MLA 多头潜在注意力
通过低秩联合投影大幅压缩键值缓存,推理显存降至常规 5%–13%,扫平 128K 长上下文商用障碍。
低秩联合压缩键值缓存将长序列开销降至常规 5%–13%,使 128K 窗口长文本推演真正具备工业普及条件。
完全基于规则奖励激发推理能力,跳过复杂监督微调冷启动,AIME 2024 与 MATH-500 测速创新高。
无辅助损失负载均衡策略彻底化解专家路由坍塌难题,以 37B 激活算力匹敌稠密超大模型吞吐表现。
免除复杂配置,认准官网认证通道一键开启深度思考,支持 PDF 报告与整库代码 128K 极速解析。
以 64 Tokens 单元自动锁定系统前缀,首字延迟骤降 80%,每百万 Tokens 输入资费压减至 ¥0.14 起。
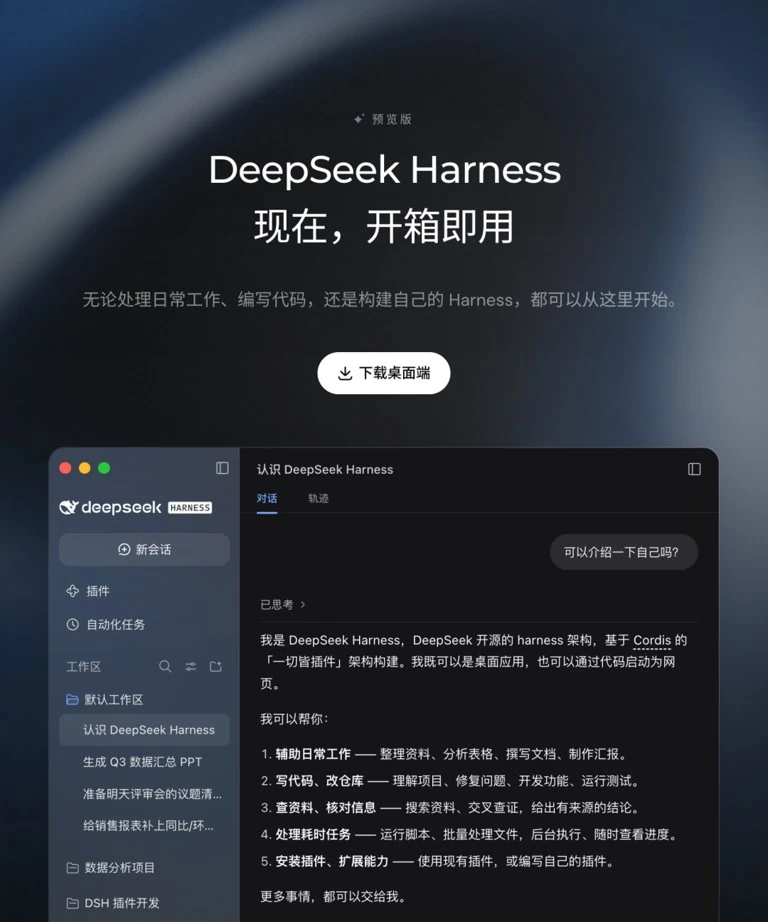
读者服务专版全时通车:DeepSeek网页版 提供随时可问的深度对话交互台;DeepSeek api开放平台 承担自动化后台持续应答;DeepSeek Harness 确保长链问答自洽不脱轨。DeepSeek - 探索未至之境,随时提问、即刻解答。
通过低秩联合投影大幅压缩键值缓存,推理显存降至常规 5%–13%,扫平 128K 长上下文商用障碍。
突破传统监督标注数据天花板,在纯规则奖励环境下自主涌现回溯试错、长逻辑验证与深度自省。
总参数 671B,每 Token 激活 37B 专家;首创无辅助损失负载均衡机制,彻底规避路由拥塞衰减。
单次支持 131,072 Tokens 全长窗口,大海捞针测试满分召回,跨文件系统级代码重构与分析从容应对。
跨仓库分析调用拓扑,自动补齐单测断言,精准定位死锁竞争与内存越界。
完整呈现数论推导引理与反证步骤,思维链环环相扣,杜绝跳步猜测。
在数百页商业交割文本中核对排他期、控制权对赌与连带保证风险条款。
剔除未来函数与因子前瞻偏见,对复杂策略滑点损耗与极端回撤复核演算。
多步工具调用连贯传递显式思维链,异常发生时自动重试避让并回归目标。
支持内网物理隔离部署,从单卡蒸馏版到 8 卡 H800 满血集群,数据完全私有化。
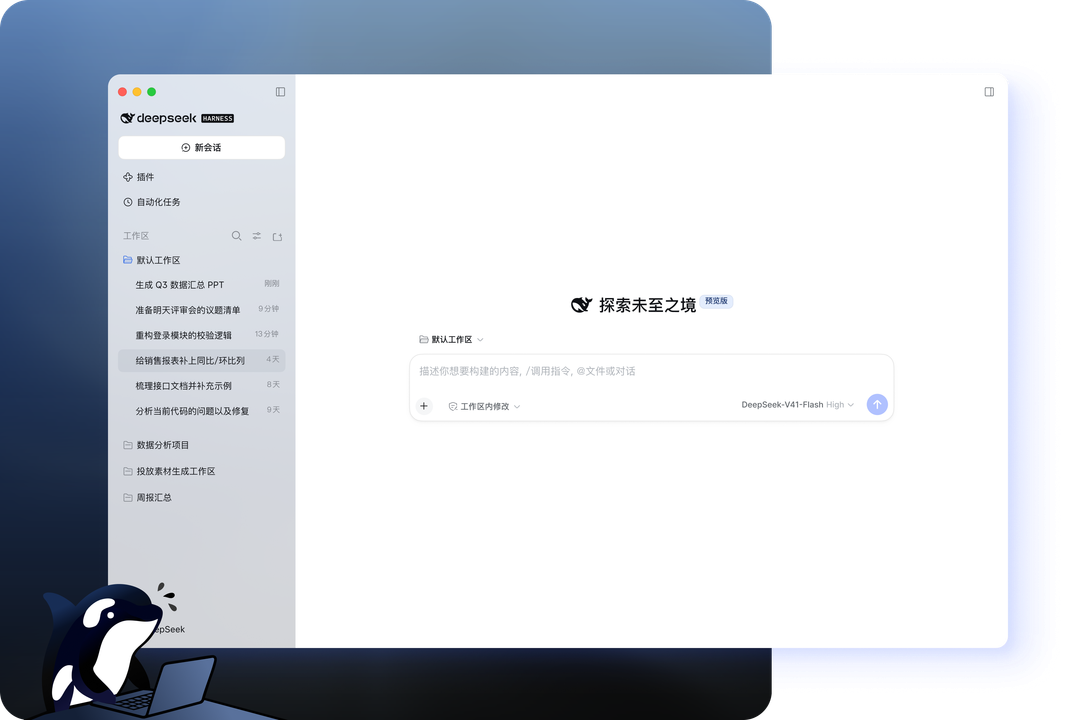
在 DeepSeek官网 开发者控制台签发专属令牌,按项目设定配额隔离。
将固定系统提示词与工具描述置顶,触发 64-token 硬盘前缀缓存低成本机制。
流式接收 reasoning_content 查验推演依据,content 写入正式出版文稿。
在隔离容器中对数千道公开数学、逻辑与代码测试集进行逐一复算,所有推导步骤均留底备查。
全量评测数据集与打分验证脚本开源提供,任何学术机构与企业均可在本地复验公布成绩单。